Как нейросеть создает видео и почему всё решает описание
2026-10-06
Нейросеть создает видео иначе, чем камера: она не снимает, а предсказывает кадр за кадром по вашему тексту. Ниже — что происходит внутри модели, как написать промпт, который она поймёт, и как выбрать инструмент под свою задачу.
Что происходит внутри модели, когда нейросеть создает видео
Модель не снимает ролик, а предсказывает его. Видеонейросеть обучалась на огромном количестве клипов с текстовыми подписями, поэтому связала слова с движением, светом, материалами и поведением объектов. Когда вы пишете «человек идёт по мокрой улице», она не ищет готовый фрагмент в базе, а достраивает сцену из того, что видела раньше.
В момент генерации модель работает не с картинкой, а с набором случайных чисел — условным шумом. Шаг за шагом шум убирается, и одновременно модель держит в голове два условия: что просили в описании и что было в предыдущем кадре. Из этого вырастает короткий ролик: обычно от нескольких секунд до пары десятков.
Самое сложное — согласовать кадры между собой, чтобы лицо, одежда и фон не плыли. Модель предсказывает движение пикселей, и если объектов в сцене много, ей труднее удержать каждый. Поэтому короткая сцена с одним действием почти всегда получается лучше, чем длинная и перегруженная деталями.
Полезно понимать и второе: у модели нет памяти о вашем прошлом запросе. Каждая генерация — новая попытка, а не продолжение предыдущей. Это объясняет, почему один и тот же промпт даёт разные результаты, и почему перебор формулировок — нормальная часть работы.
Как нейросеть создает видео по текстовому описанию
Путь простой: вы пишете текст, выбираете модель и запускаете генерацию. Модель превращает описание в последовательность кадров, добавляет движение и отдаёт готовый файл. Рендер идёт на стороне сервиса, поэтому от вашего устройства нужен только браузер или телефон.
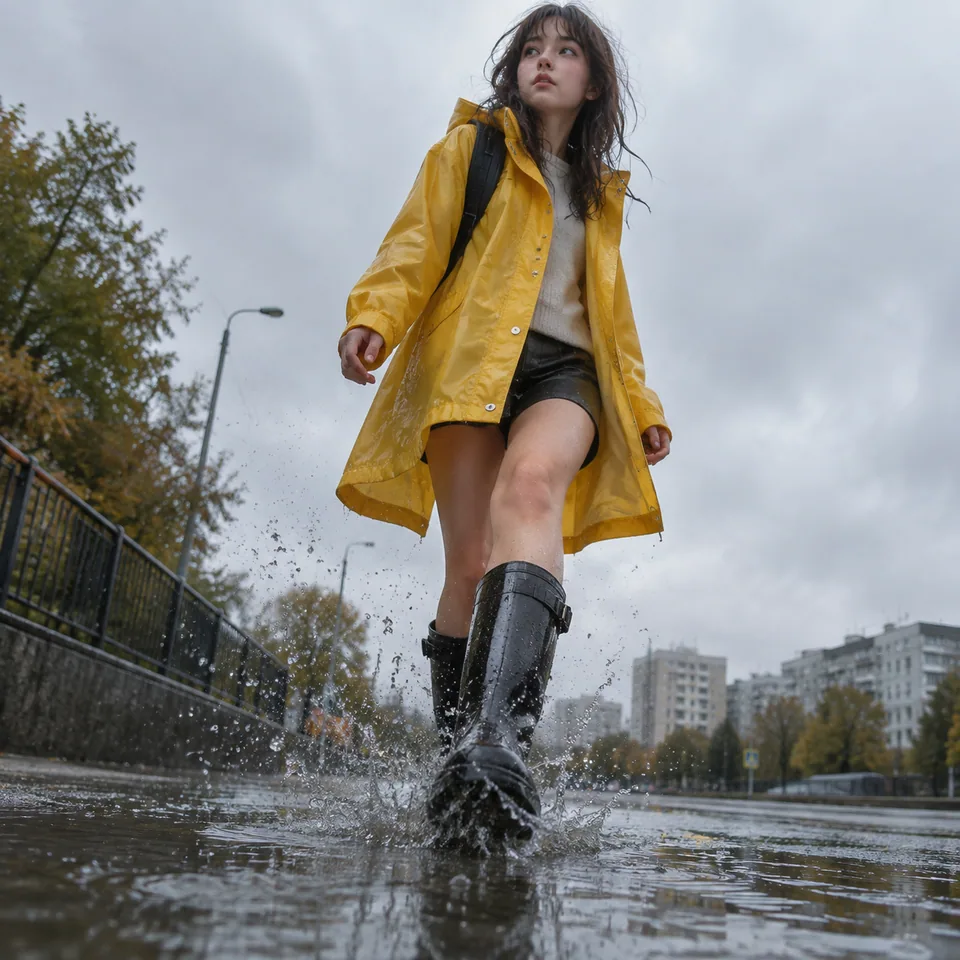
В промпте полезно указать четыре вещи: кто или что в кадре, что происходит, как ведёт себя камера и как выглядит сцена. Например: женщина в жёлтом плаще идёт по мокрому асфальту, камера медленно едет сбоку, вечерний свет, отражения в лужах. Такой запрос модель понимает почти без домысливания.
Чем конкретнее действие и свет, тем меньше модель решает за вас. Нужен определённый стиль — мультфильм, рекламный ролик, документальная съёмка, анимация в духе рисованных комиксов — скажите об этом прямо. Стиль описывается одним-двумя словами, и это сильно меняет картинку.
Отдельно про язык. Промпт можно писать по-русски: модели понимают смысл описания, а не ищут точное совпадение слов. Если результат выглядит не так, как вы представляли, дело чаще не в языке, а в нехватке деталей — ракурса, времени суток, скорости движения.
Почему результат зависит от промпта: примеры
Сравните два описания. Первое: красивый город, видео. Второе: ночной город сверху, камера медленно опускается к улице, неон, лёгкий дождь, отражения фар. В первом случае модель выберет всё сама и выдаст что-то усреднённое, во втором вы задали ракурс, движение и атмосферу — и получите предсказуемую сцену.
Ещё одно правило: одно видео — одно действие. Если в промпте человек и бежит, и садится в машину, и машет рукой, модель начнёт путаться, и части тела поедут. Разбейте сцену на несколько генераций и соберите их вместе — так надёжнее, чем пытаться уместить всё в один клип.
Третье: не описывайте то, чего в кадре быть не должно. Формулировки с отрицанием модель часто понимает буквально и всё равно рисует упомянутый объект. Вместо «без людей на заднем плане» лучше описать пустую улицу.
И не бойтесь переписывать: удачная формулировка обычно находится с третьей-четвёртой попытки. Сохраняйте те промпты, которые сработали, — из них получается личная библиотека рабочих описаний.
Видео через нейросеть: какие подходы бывают
Текстовые модели (text-to-video) делают ролик с нуля по описанию. Модели фото в видео (image-to-video) берут вашу картинку и добавляют движение: оживляют портрет, облетают товар камерой, превращают статичный кадр в короткую сцену. Это удобно, когда важна точность: лицо, логотип на упаковке или конкретный кадр остаются теми же, меняется только движение.
Отдельная категория — говорящие аватары: человек на видео произносит ваш текст, это пригодится для обучающих роликов, презентаций и приветствий. Здесь задача модели — не придумать сцену, а согласовать губы и мимику со звуком.
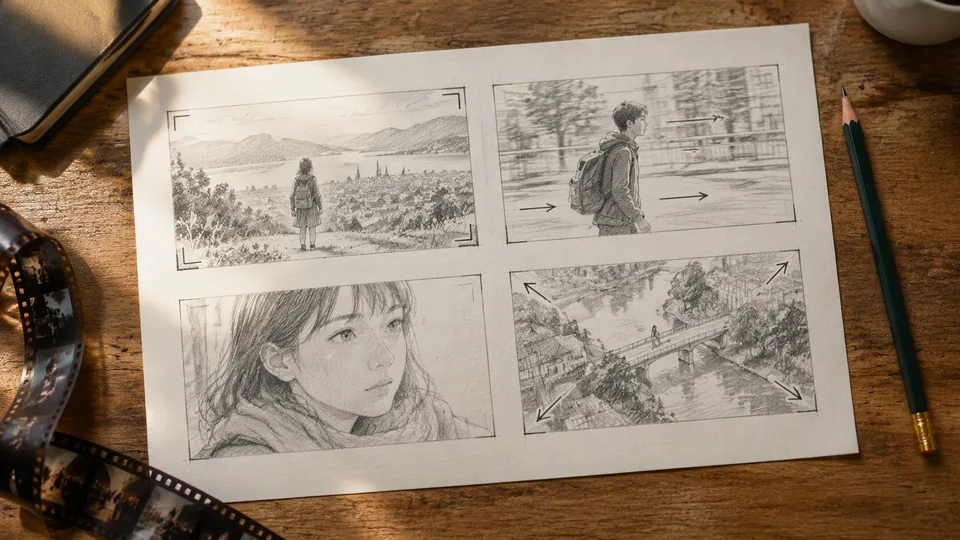
Есть и четвёртый путь: не генерировать видео целиком, а собрать его из ИИ-изображений и озвучки. Так проще контролировать детали: каждый кадр вы проверяете отдельно, а движение появляется за счёт монтажа и смены планов.
На Tokion доступны модели Veo, Kling, Seedance, MiniMax, Runway и Grok Video, включая генерацию видео из фото, и всё это в одном чате: на сайте tokion.io/ru или в Telegram-боте @tokionaibot. Интерфейс на русском, работать можно из любой страны, а изображения для оживления можно тут же сгенерировать или отредактировать.
Какая нейросеть создает видео лучше и как выбрать
Единого победителя нет: у моделей разные сильные стороны. Одни точнее держат реалистичных людей и лица, другие лучше справляются с динамикой и движением камеры, третьи — со стилизованной графикой и анимацией. Модель, которая отлично рисует пейзажи, может растеряться на крупном плане человека.
Проще всего выбрать так: решите, что для вас важнее — реализм, движение, стиль или оживление конкретного фото, — и прогоните одну и ту же задачу через две-три модели. Разница видна сразу, и вы быстро поймёте, что подходит именно вашему контенту.
Второй критерий — удобство. Когда модели собраны в одном месте, не нужно отдельно регистрироваться в каждом сервисе, заново разбираться в интерфейсе и переключаться между вкладками. Вы сравниваете результаты в одном окне и там же их правите.
Третий критерий — предсказуемость. Если модель стабильно выдаёт нужный тип сцен с первых попыток, это важнее, чем единичный впечатляющий результат после десяти перезапусков.
Создание видео с помощью нейросети: чего ожидать
Первая генерация почти никогда не становится финальной. Часть кадров выйдет с артефактами: лишние пальцы, плывущие буквы, странная физика движения, внезапная смена одежды. Это нормально для всех видеомоделей, а не только для одной, и не значит, что вы что-то делаете не так.
Дальше вы правите формулировку, убираете из промпта лишнее, сокращаете сцену до одного действия и пробуете снова. Такой цикл из нескольких подходов экономит время: вместо долгой охоты за одной идеальной моделью вы быстрее получаете рабочий результат.
Заранее решите, нужен ли звук. Часть моделей отдаёт видео без дорожки, и тогда музыку или голос добавляют отдельно, уже при монтаже. Если ролик планируется для соцсетей, сразу думайте о вертикальном кадре — не все сцены одинаково хорошо смотрятся в горизонтальном формате.
И проверьте результат на телефоне. Артефакты, незаметные на большом экране в превью, на маленьком часто бросаются в глаза, а именно там большинство зрителей и увидит ваш ролик.
Приложение нейросеть видео и онлайн на русском
Видеогенерация не требует мощного компьютера: рендер идёт на стороне сервиса, вам нужен только браузер или телефон. Удобно, когда чат с моделями и генерация видео живут в одном окне: написали промпт, посмотрели результат, тут же попросили поправить сцену или сделать вариант короче.
На Tokion это веб-чат на tokion.io/ru и Telegram-бот @tokionaibot. Кроме видео там есть генерация и правка изображений, ИИ-фотосессии, десятки готовых инструментов для фото и доступ к API. Всё в одном аккаунте и с одним балансом, поэтому не приходится держать пять подписок ради пяти разных задач.
Оплата — пополнение общего баланса, без подписки. При регистрации начисляется стартовый баланс: на нём можно попробовать генерацию и понять, как это работает на ваших задачах, прежде чем пополнять баланс дальше.
Попробовать
Вопросы
Как нейросеть создает видео по текстовому описанию?
Вы пишете промпт, выбираете модель и запускаете генерацию: сервис считает последовательность кадров и отдаёт готовый файл. Чтобы результат был предсказуемее, укажите объект, действие, движение камеры и свет. Одно видео — одно действие: так модель ошибается реже, а сцену при необходимости легко разбить на несколько генераций.
Какая нейросеть лучше для создания видео?
Зависит от задачи: одни модели сильнее в реалистичных людях, другие — в динамике и работе камеры, третьи — в стилизованной графике. Надёжный способ выбрать — прогнать один и тот же промпт через две-три модели и сравнить. На Tokion модели Veo, Kling, Seedance, MiniMax, Runway и Grok Video собраны в одном чате, так что сравнить можно без лишних регистраций.
Какие бесплатные нейросети создают видео?
Бесплатного безлимитного доступа к видеогенерации нет: рендер видео требует ресурсов, поэтому генерации оплачиваются с баланса. При регистрации на Tokion начисляется стартовый баланс — на нём можно попробовать генерацию и оценить результат на своей задаче. Подписка не нужна: вы пополняете общий баланс и тратите его по мере необходимости.
Можно ли сделать видео из одного фото?
Да, для этого есть модели фото в видео: они берут вашу картинку и добавляют движение — оживляют портрет, облетают товар камерой, превращают статичный кадр в короткую сцену. Этот путь удобен, когда важна точность: лицо или конкретный кадр остаются теми же, меняется только движение. На Tokion видео из фото делается в том же чате, где вы работаете с изображениями.
Сколько попыток нужно, чтобы получить хороший ролик?
Обычно от двух до пяти: первая генерация показывает, как модель поняла промпт, дальше вы уточняете детали и убираете лишнее. Если сцена сложная, помогает разбить её на короткие фрагменты по одному действию. Сохраняйте удачные формулировки — из них складывается личная библиотека рабочих промптов.
Как удалить созданные из фото стикеры?
Сначала стикер нужно создать — например, в инструменте для наклеек из фото на Tokion. Все генерации сохраняются в истории чата, поэтому ненужный результат можно найти там и удалить, а сам файл стикера — из сохранённых на устройстве или в переписке. Если генерация не понравилась, её проще пересоздать с уточнённым описанием, чем править вручную.